每日学习笔记|RAG 不是向量数据库:检索、证据与幻觉控制
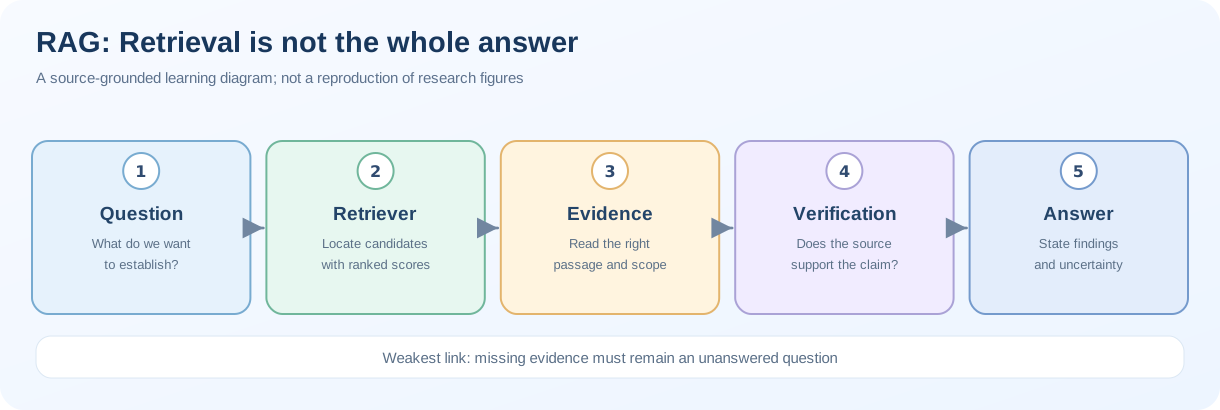
RAG 专题学习笔记。 这是按学习时间线整理的技术笔记,不是当日科技新闻。主要依据 Lewis 等人 2020 年的 RAG 论文、公开技术资料和已获得字幕的相关 B站教程。YouTube 的 LangChain 教程可作为延伸视频,但本次没有成功读取它的完整字幕,因此不将其讲解内容当作本文的直接证据。
一、为什么让模型“查资料”,仍可能回答错误?
想象你在问一个科研问题:“某个市场出现负电价时,应该如何判断产生原因?”模型不一定知道该市场当时的交易规则,也未必掌握最新数据。让模型先找到市场说明、公开报告和相关论文,通常比仅凭参数记忆回答更有依据。
但有资料不等于有正确答案。检索失败会让模型看错文档,阅读失败会让模型误解段落,生成失败则可能让模型引用了资料却仍说出资料不支持的结论。
这三种失败必须分开检查。

图 1|原创示意:先检索再生成只是 RAG 的数据流;额外的“证据核对”是本文建议增加的可靠性门禁,并非原论文默认具有的万能防幻觉功能。
二、RAG 的核心不是数据库,而是条件化生成
经典 RAG 将语言模型的参数知识与外部可检索文档结合。设问题为 、文档为 、输出为 。对“选择一组检索结果再生成”的教学简化,可以写作:
表示检索器认为文档 与问题相关的权重; 表示给定问题与文档后的生成概率。
这个式子是帮助理解的简化混合模型,不是所有工程 RAG 系统都照此公式训练。原论文还区分了对整段输出使用相同文档的 RAG-Sequence,以及允许不同 token 借助不同文档的 RAG-Token。日常系统里的“向量召回 → 拼接上下文 → 调用 API”,可能只实现了其中较简化的操作流程。
所以,向量数据库是可能采用的检索基础设施,而不是 RAG 的同义词。检索器可以是 BM25、向量检索或混合检索;重要的是能否找到与当前问题真正相关的证据。
三、检索系统应该先测“找到了没有”
假设我们自己写了一小份知识库,人工标注 20 个问题对应的正确资料。对每个问题检索前 篇文档,如果至少含有一篇人工标注的相关文档,就记为命中。那么:
这里 是问题数量, 是对第 个问题人工确认的相关文档集合。这叫Hit@k / 检索命中率;它不等于严格意义上“召回全部相关文档”的 Recall@k,更不等于最终回答准确率。
再举个例子:20 个问题里有 16 个至少检索到一份相关资料,则 。即使如此,后续模型仍有可能误读其中一段规则,最后的回答准确率可能低于 80%,也可能在部分没有命中的问题上依靠其他知识答对。两种指标没有可以随意替换的恒等关系。
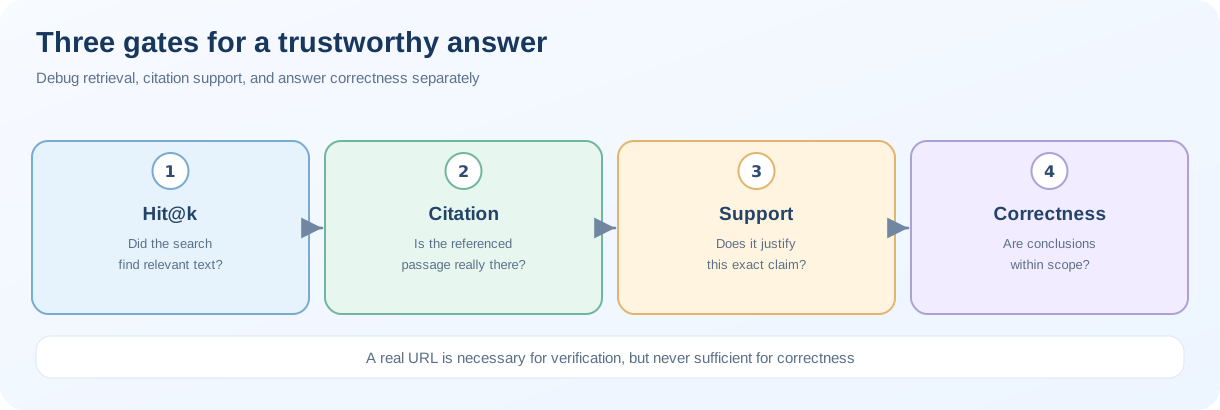
图 2|原创示意。每道门检查不同错误来源;只有“引用来源存在”而没有“引用确实支持论断”,仍然可能产生带引用的幻觉。
四、“模型给出了来源”为什么还不够?
例如,模型回答:“这份论文证明方法 A 在任何市场、任何年份都优于方法 B”,后面附了一条文献链接。你点开却发现论文仅测试一个国家、一个月份和两个基线。引用链接是真实的,但结论范围被偷偷扩大了。
一个比较可靠的回答,可以将每条重要论断拆成三种状态:
- 原资料陈述:论文、官方规范或视频作者明确说过什么。
- 由多份证据支持的解释:数值、环境和适用边界相互吻合,但仍需说清推断过程。
- 待验证猜测:目前只是一个值得复现实验的方向,不能升级为既定科研结论。
第三种并不丢人。对科研来说,知道“目前没有证据”往往比生成一个貌似自信的答案更有价值。
这也是为什么直接把整篇论文塞进知识库未必最优:资料质量、问题检索、证据定位、结论验证共同决定系统是否可靠。
五、今天可以做的最小可复现实验
先别一上来搭建复杂 Agent。选一份公开软件说明文档或几篇允许使用的论文,准备 20 个具体问题,并人工记录“正确依据在哪一段”。然后用两个方案做对照:
- 方案 A:直接把问题交给模型,关闭外部检索。
- 方案 B:先检索原文,再把检索段落交给同一模型。
两个方案用相同问题和可比的模型设置,记录 Hit@5、最终答案正确率、引文支持比例、每题耗时。失败问题要标注是“检索没找到”“找到了却误读”“引用不支持结论”,而不是只报告一个总分。
这个实验不保证方案 B 一定获胜;但它能告诉你在一个新研究领域中,到底是应该调整索引、重写查询、换模型,还是改验证规则。
六、这篇笔记的边界
RAG 不能证明外部资料天然正确。低质量网页、过时标准、误标的实验表格被检索到以后,模型同样可能扩散错误。你真正需要建立的是可核验、能撤回、带版本号的知识系统,而不是一个永远只增加文档的资料仓库。
本文的公式和举例服务于理解;没有运行新的 RAG benchmark,也没有声称对现有项目做了性能提升。
资料来源与边界
- Lewis et al. (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks —— RAG-Sequence 与 RAG-Token 原始研究依据。
- LangChain:RAG From Scratch 第一讲(YouTube) —— 延伸学习入口;本次已核对公开视频元数据,但未取得完整字幕,故不把其内容当成本文实证来源。
- B站:Agent + Skill + MCP + 私有化 RAG 科研工作流 —— 已获得本地 290 条带时间戳 ASR 字幕和精选关键画面,文中涉及知识库质量与流程化思考的动机与该视频相关。
- 所有 SVG 与指标举例由本文独立构造,不代表任何论文的原始实验图和性能结果。
整理说明:本文日期是笔记归档时间,引用的论文和视频有各自的实际发布日期。